🗺 Карта раскрытия информации: чем объяснять ИИ и чего это стоит
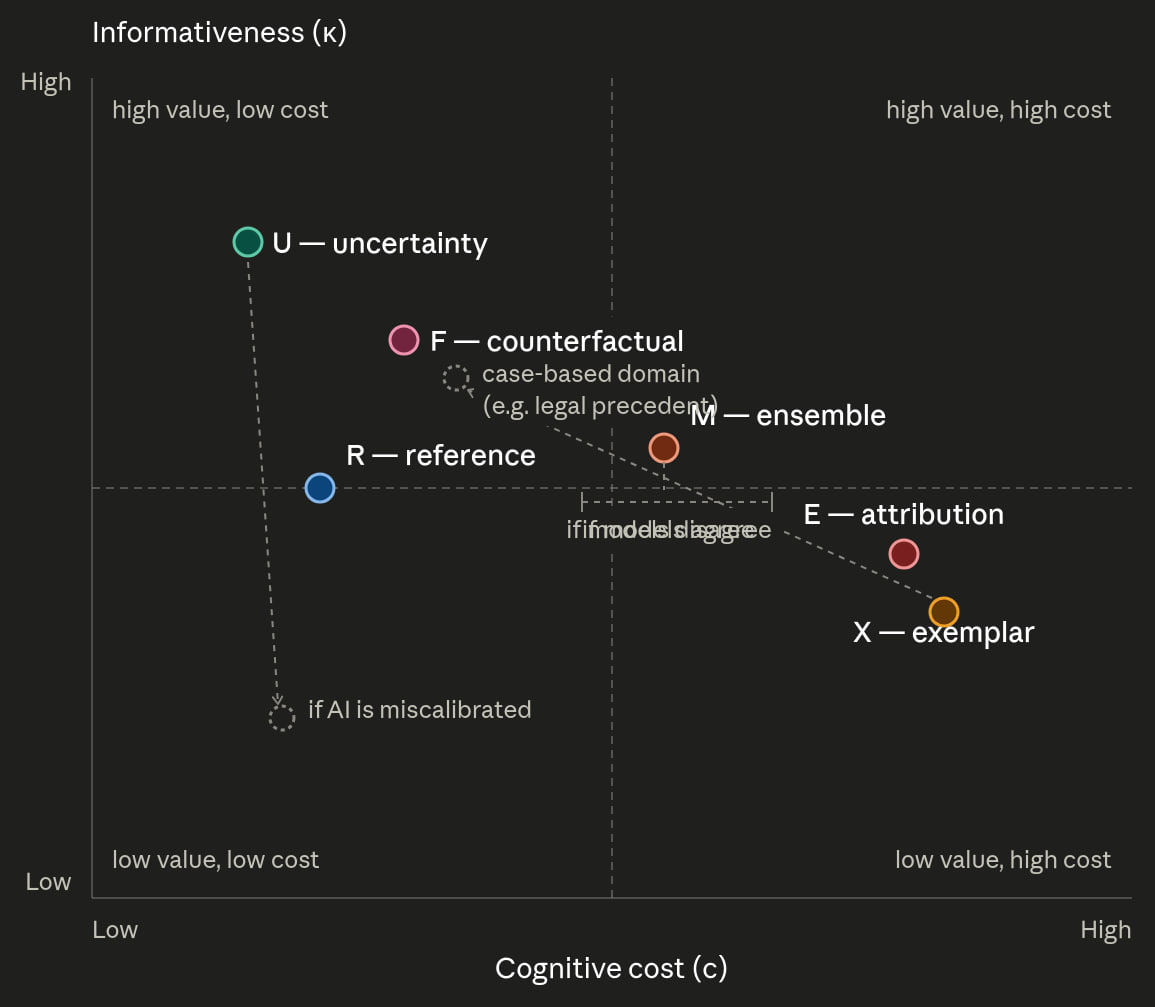
При проектировании систем с объяснимым ИИ (XAI) существует множество “техник”, предлагающих в дополнение к решению ИИ выдавать различные “блоки информации”. Казалось бы, чем больше всего показать, тем лучше. Но, вместе с дополнительной информацией растет когнитивная нагрузка, а еще - растет неопределенность (особенно, если внезапно эти блоки противоречат друг другу). Например, можно выделить такие категории “блоков информации”:
🔠 Референс/якорь: внешняя, независимая от ИИ шкала (клинический риск-скор, регуляторный порог). Хорошо изучен в классической литературе по эффекту якоря. Работает, если сам якорь откалиброван, и вредит, если нет.
🔠 Атрибуция: post-hoc объяснение вклада признаков (SHAP, LIME). Несмотря на популярность, накопленный массив исследований показывает слабый и часто нулевой эффект на точность решения при высокой когнитивной цене.
🔠Контрфактуал: «что должно было измениться, чтобы вывод был другим». Неожиданно воспринимается как менее понятный, но по крайней мере в одном сравнительном исследовании повышает точность и снижает нагрузку сильнее, чем E.
🔠 Пример/прецедент: похожие случаи. Хорошо работает в кейс-ориентированных областях (юриспруденция), но на табличных клинических данных скорее повышает нагрузку, чем снижает.
🔠 Неопределённость: калиброванная уверенность модели. Самый изученный и самый “условный”: помогает при честной калибровке [4], но при рассинхронизации между заявленной и фактической точностью не просто теряет пользу, а снижает эффективность решения.
🔠 Согласие ансамбля: расхождение между независимыми моделями/источниками. Изучен слабее остальных; асимметричен по цене — дёшев при согласии моделей, дорог при разногласии.
🗺 При этом фрагменты отнюдь не одинаковы по характеристикам. Например, можно оценить их информативность и формируемую когнитивную нагрузку (см. рисунок). Понятно, что такая “карта” может сильно меняться от контекста: неопределенность (U) резко проигрывает по информативной ценности при плохой калибровке ИИ [1]; согласованность ансамбля (M) может сильно меняться от структуры ансамбля; позиция примеров (X) зависит от того, насколько предметная область изначально «кейс-ориентирована» и т.п.
☁️ Кроме того, контекстом может быть: сложность задачи [2, 3] (высокая когнитивная нагрузка цена окупается только на сложных случаях); экспертиза пользователя [4, 5] (эксперты по определению обесценивают внешнюю информацию сильнее новичков); дефицит времени [6] (высокая когнитивная нагрузка срабатывает раньше, чем успевает реализоваться полезность решения ИИ); корректность самой рекомендации ИИ [7] (объяснения повышают доверие к верным ответам ИИ и ухудшают ситуацию в ошибочных) и т.п.
🤔 Тем не менее, проводя такие оценки можно попытаться оптимизировать состав “блоков информации”, представляемых ИИ с учетом того, насколько они помогают, мешают, затрудняют и пр. принятие решений при работе СППР.
Ссылки:
[1] Understanding the Effect of Accuracy on Trust in Machine Learning Models
[2] A Missing Piece in the Puzzle: Considering the Role of Task Complexity in Human-AI Decision Making
[3] Explanations Can Reduce Overreliance on AI Systems During Decision-Making
[4] Algorithm Appreciation: People Prefer Algorithmic to Human Judgment
[5] Investigating appropriate reliance on AI-based decision support systems: the role of expertise, trust, and self-confidence
[6] Accuracy-Time Tradeoffs in AI-Assisted Decision Making under Time Pressure
[7] Does the Whole Exceed its Parts? The Effect of AI Explanations on Complementary Team Performance