🎪 Арены
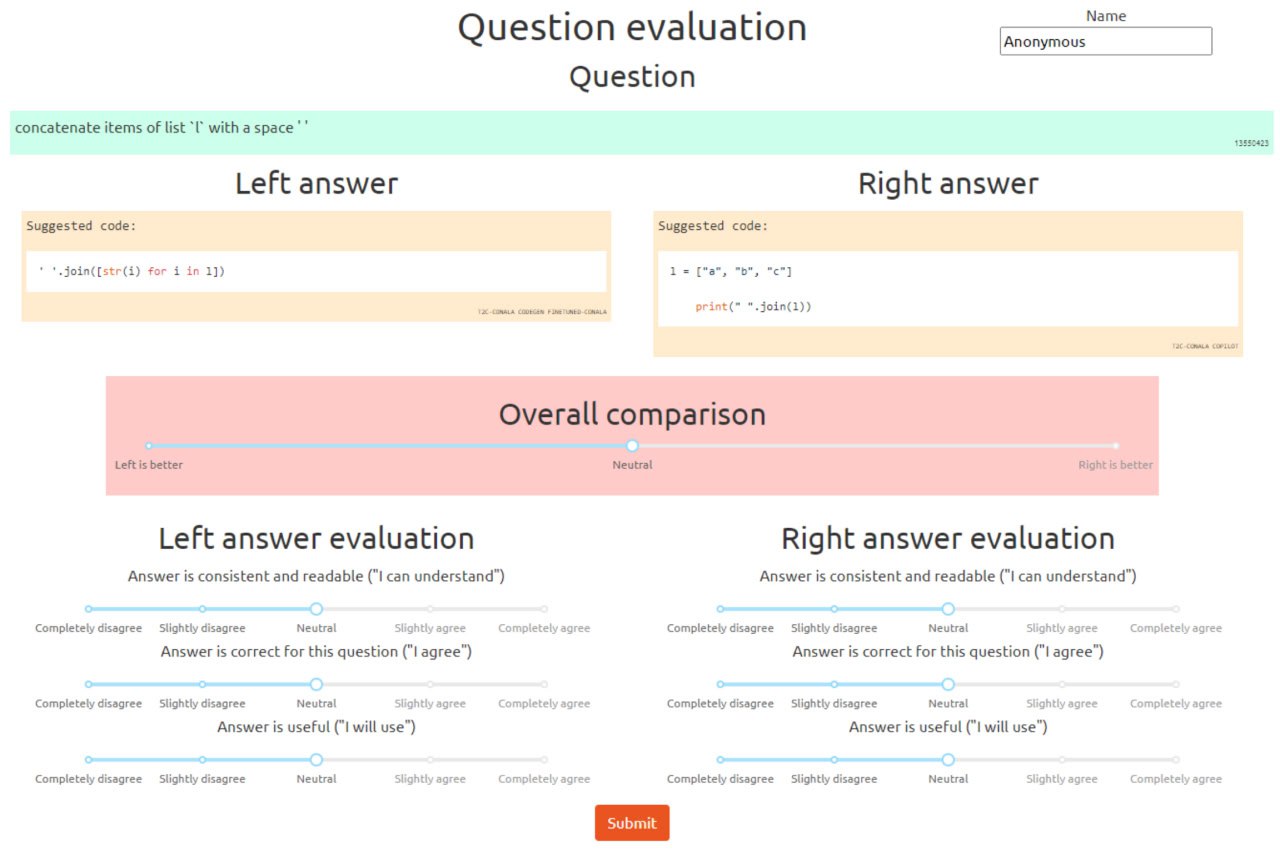
⚖️ Одним из распространенных вариантов получения обратной связи от людей (human feedback, HF) для обучения LLM является попарное сравнение альтернативных решений. Одним из классических известных решений еще в 2021 г. был WebGPT [1], использующий попарное сравнение для экстраполяции в вознаграждение генерации в рамках классического RLHF. Попарное сравнение а) имеет хорошую формализацию (в простейшем случае - бинарный выбор лучшего); б) хорошо нормируется и не дает смещения ввиду различной “строгости” оценщиков; в) дает понятную постановку задач для опроса, что облегчает привлечение людей. Как следствие такой подход активно используется в рамках RLHF сравнивая как генерацию одной и той же моделью, так и разными моделями. Как раз последний вариант сейчас достаточно популярен в рамках концепции “арен” для сопоставления моделей. Причем арены существуют как общие (LM Arena, LLM Arena RU), так и специализированные (CoPilot Arena [2]). Мы в рамках сравнения моделей генерации кода также использовали эту концепцию [3] (см. рисунок).
🤔 Естественно, минусы тоже присутствуют: оценщику приходится разбираться с двумя задачами одновременно вместо одной; для более сложных задач одномерное сравнение может быть неэффективно - в частности, оценки “лучше-хуже” могут трактоваться людьми по-разному; возможны специфичные смещения оценок и даже хуже - манипуляции предпочтением; также возможные технические ограничения представления задач (особенно для сложных предметных областей) и пр.
🎛 Тем не менее, арены остаются одним из наиболее актуальных инструментов для оценки LLM - даже разрабатываются фрэймворки для их построения [4]. Также данные из арен активно применяются для построения моделей LLM-as-a-Judge.
🤫 А еще в аренах иногда можно получить бесплатный доступ к очень большим моделям, которые в обычном режиме требуют оплаты.
Ссылки:
[1] WebGPT: Browser-assisted question-answering with human feedback
[2] Copilot Arena: A Platform for Code LLM Evaluation in the Wild
[3] Human perceiving behavior modeling in evaluation of code generation models
[4] am-ELO: A Stable Framework for Arena-based LLM Evaluation